持续更新 · 大模型对比报告 · 2026-07-09 → 08-29 | 08-29 更新:腾讯混元 Hy4 preview 开源,加入对比

「斩杀线」之下
Kimi K3 · GLM-5.3 · 千问 3.8 Max · 混元 Hy4
V4 Pro · Grok 4.6

网传「除 GPT、Claude 外全部进入 DeepSeek V4 Flash 斩杀线」——我们用有出处的公开数据重画这张图;08-28 腾讯混元 Hy4 preview 开源,同步加入对比: 斩杀线在性价比维度成立,但国产新旗舰的绝对能力不再低于 V4 Flash。

DATA: OFFICIAL PRICING + SWE-BENCH VERIFIED + AA INTELLIGENCE INDEX | AS OF 2026-08-29 · FLASH 对决见第 05A 节

0×
调价后千问 3.8 Max / V4 Flash 输出价倍数:8.7× 非高峰,4.4× 高峰($5.76 vs $0.66–1.32)
0%
千问 3.8 Max 的 SWE-bench Verified——本文六款模型中的国产最高分
0分
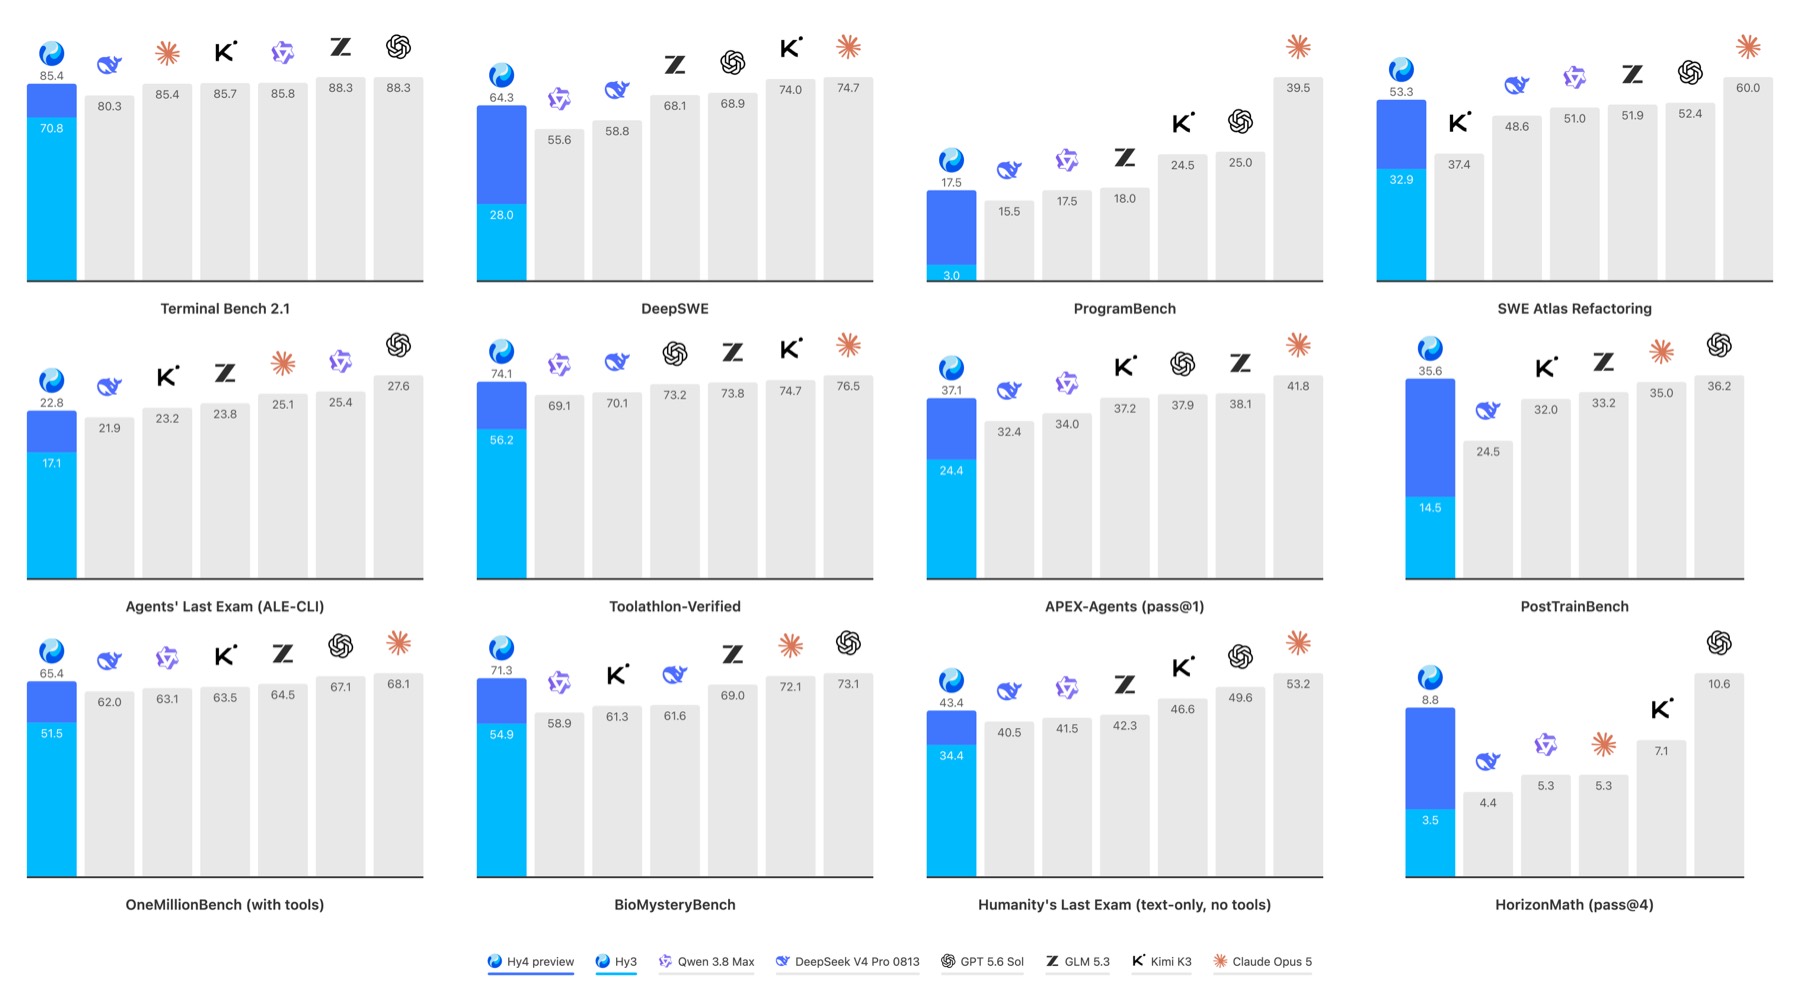
混元 Hy4 preview 的 Terminal-Bench 2.1 得分(官方自报,与 GLM-5.3 的 88.2 同版口径)——08-28 开源
01

最近 30 天发生了什么

三个模型在 10 天内接连发布,「Token 战争」开打;两周后,「斩杀线」图刷屏。

07-17
Kimi K3 发布
1T/35B MoE,1M 上下文,开源。K2 流量单日暴跌 60%,「Token 战争」成话题。
07-22
GLM-5.2 发布
主打 Agentic Engineering;「高达测评泄露」事件称其真实任务首胜 Claude。(08-14 被 GLM-5.3 接替)
07-26
千问 3.8 Max 发布
SWE-bench 82.3%、Terminal-Bench 2.3 67.5%;发布当日阿里股价涨 6.8%。
07-31
DeepSeek 注水争议
被曝 API 对话默认注入 Codex 环境上下文,benchmark 口径引讨论。
08-03
「斩杀线」图刷屏
多个 AI 生成变体流传:「除 GPT/Claude 外,全部进入 V4 Flash 斩杀线」。
08-06
涨价公告 · Pro 临近
DeepSeek 官宣 API 大幅涨价;灰度中的 V4 Pro 正式版预计 8 月内发布。
08-12
Grok 4.6 发布
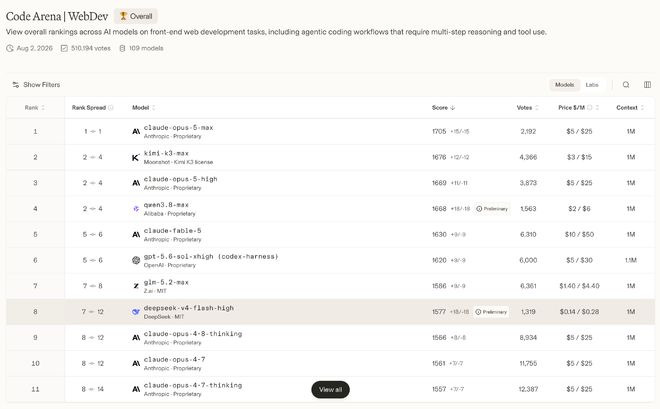
xAI 新旗舰:AA 指数 61 追平 Claude Opus 5,每任务成本仅 $0.65,溢出区首次出现价格挑战者。
08-13
V4 Pro 正式版发布
deepseek-v4-pro:旧价输出 $0.87/M,AA 指数 58 / 每任务 $0.06。斩杀线从 50 分抬到 58 分,绿色预测成为现实;08-17 起改峰谷价。
08-14
GLM-5.3 发布(接替 5.2)
同 5.2 基座 + 长任务 RL 后训练:Terminal-Bench 2.1 81.0→88.2、DeepSWE 46.2→66.9;开源权重约 8 月底放出,AA 指数/API 定价未公布。
08-17
DeepSeek 峰谷价正式生效
V4 Flash 输出 $0.66–1.32/M,V4 Pro $1.98–3.96/M;北京 09–12、14–18 为高峰,其余时段半价。价格优势从全天候变成「错峰仍强,高峰收窄」。
08-26
GLM-5.3 Flash 发布
原生多模态、1M 上下文、AA 57 分;API 限时半价至 09-09,正式把 Flash 竞争从「纯文本低价」推进到「视觉交付总成本」。
08-28
混元 Hy4 preview 开源
腾讯新一代开源旗舰:770B/49B MoE、1M 上下文、Apache 2.0;官方自报 TB 2.1 88.4、SWE-bench V. 82.7,内部盲评小幅领先 GLM 5.3 与 K3;AA / 第三方复测待收录。
02

网传原图(高清版),以及它的三个问题

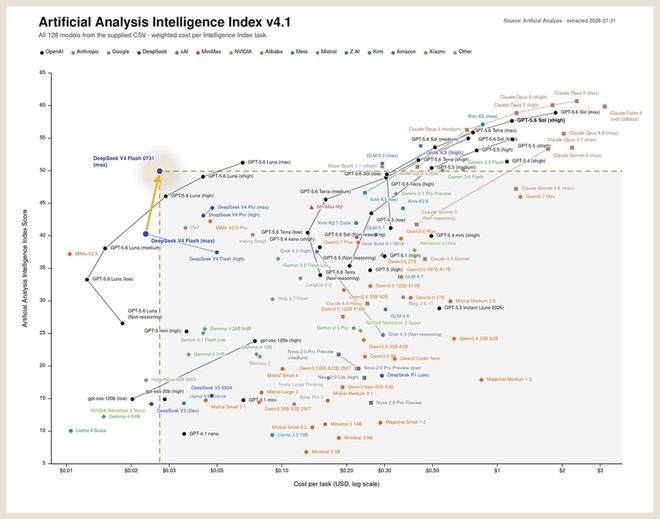
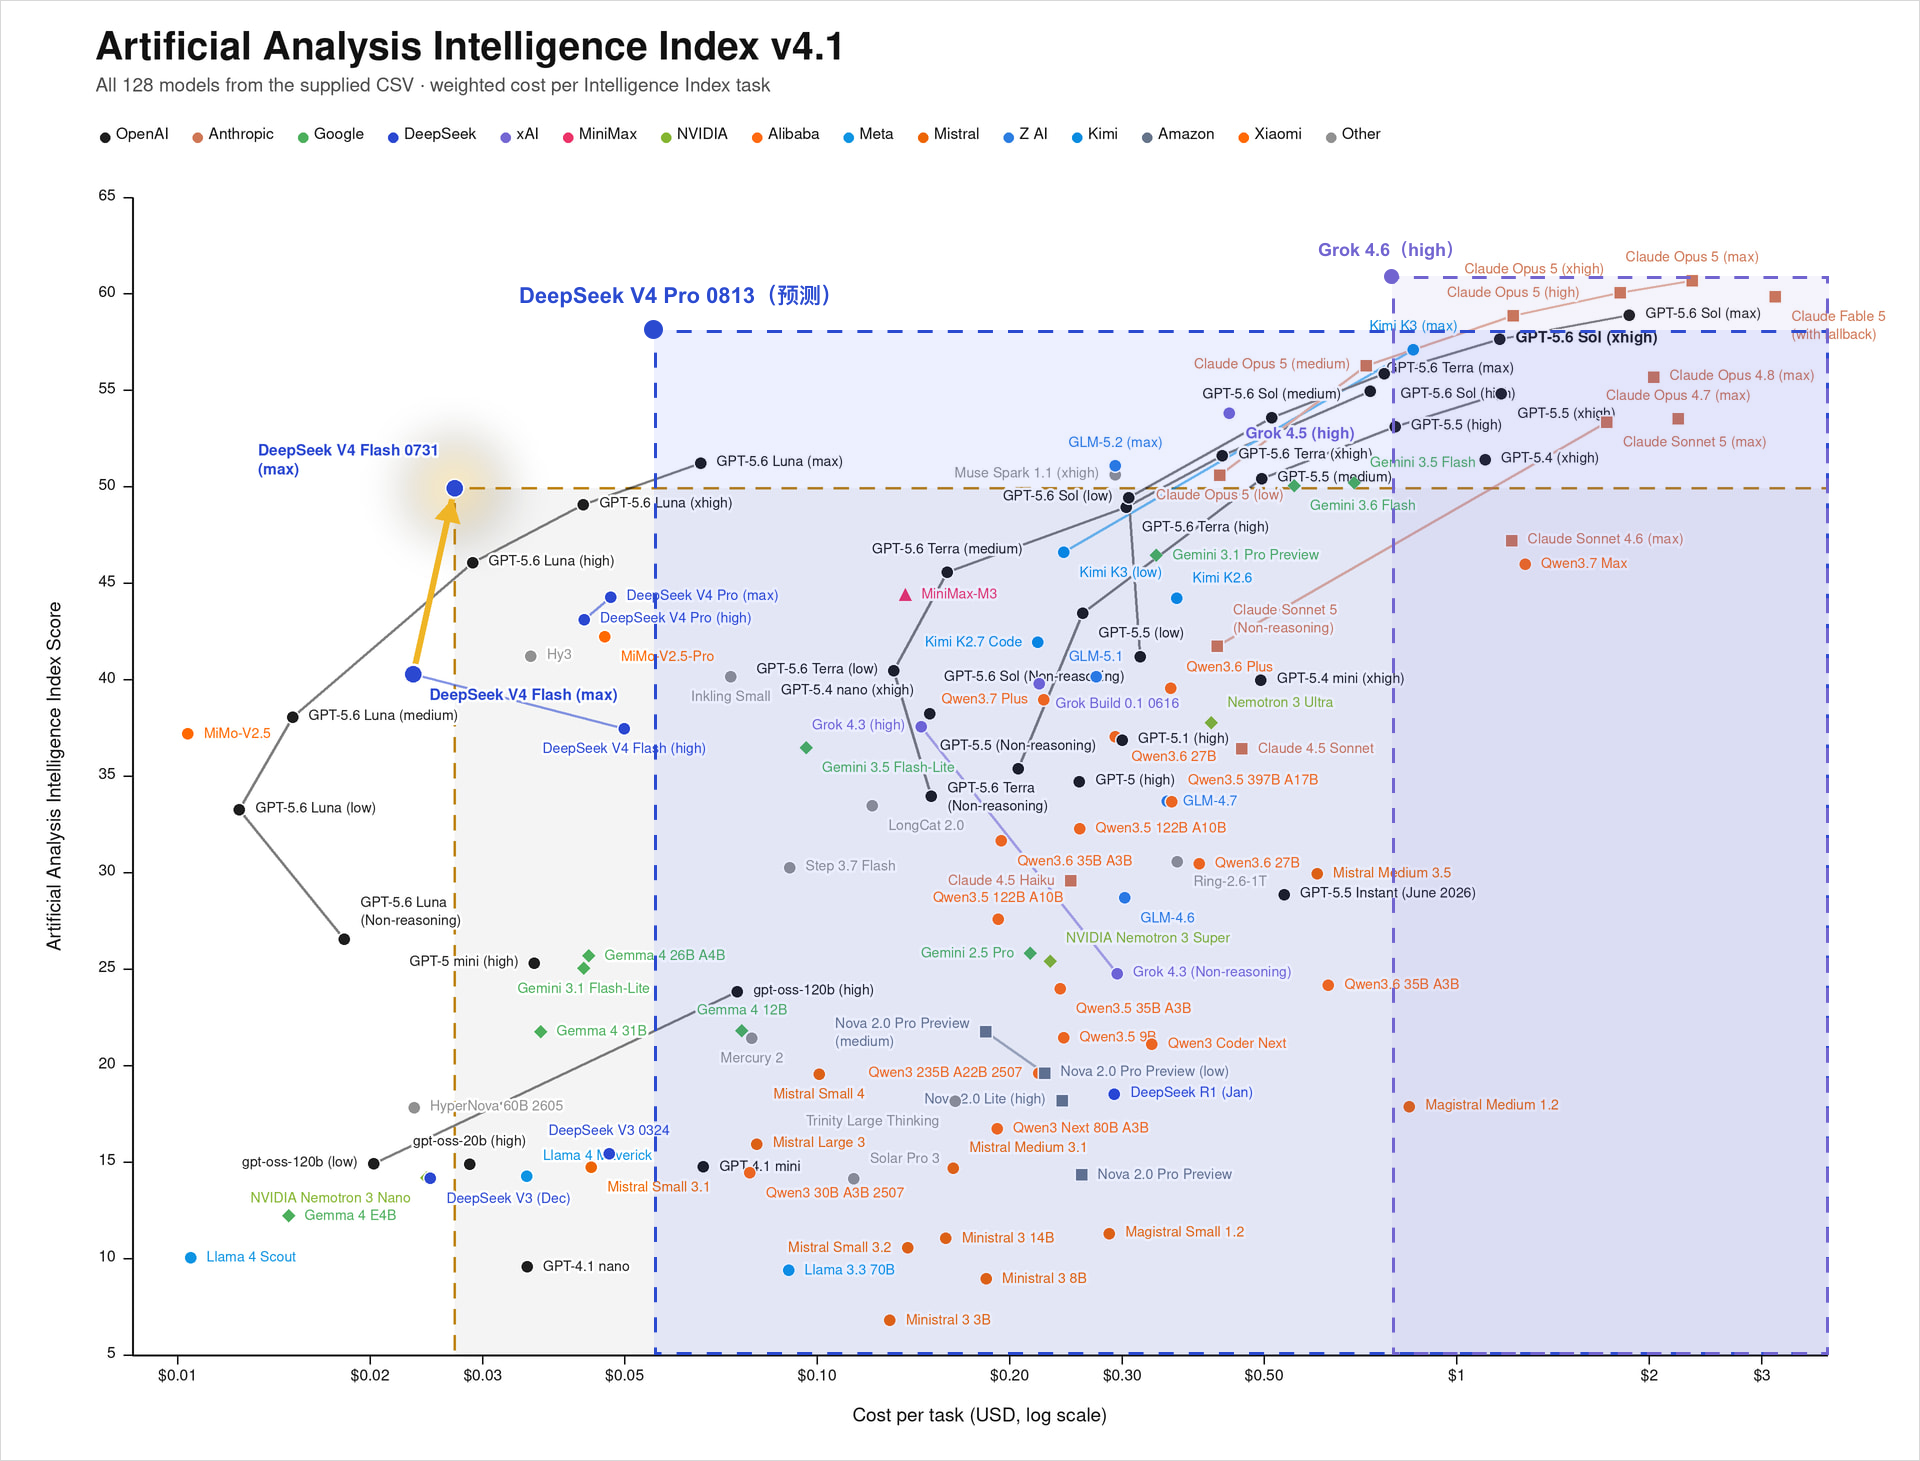
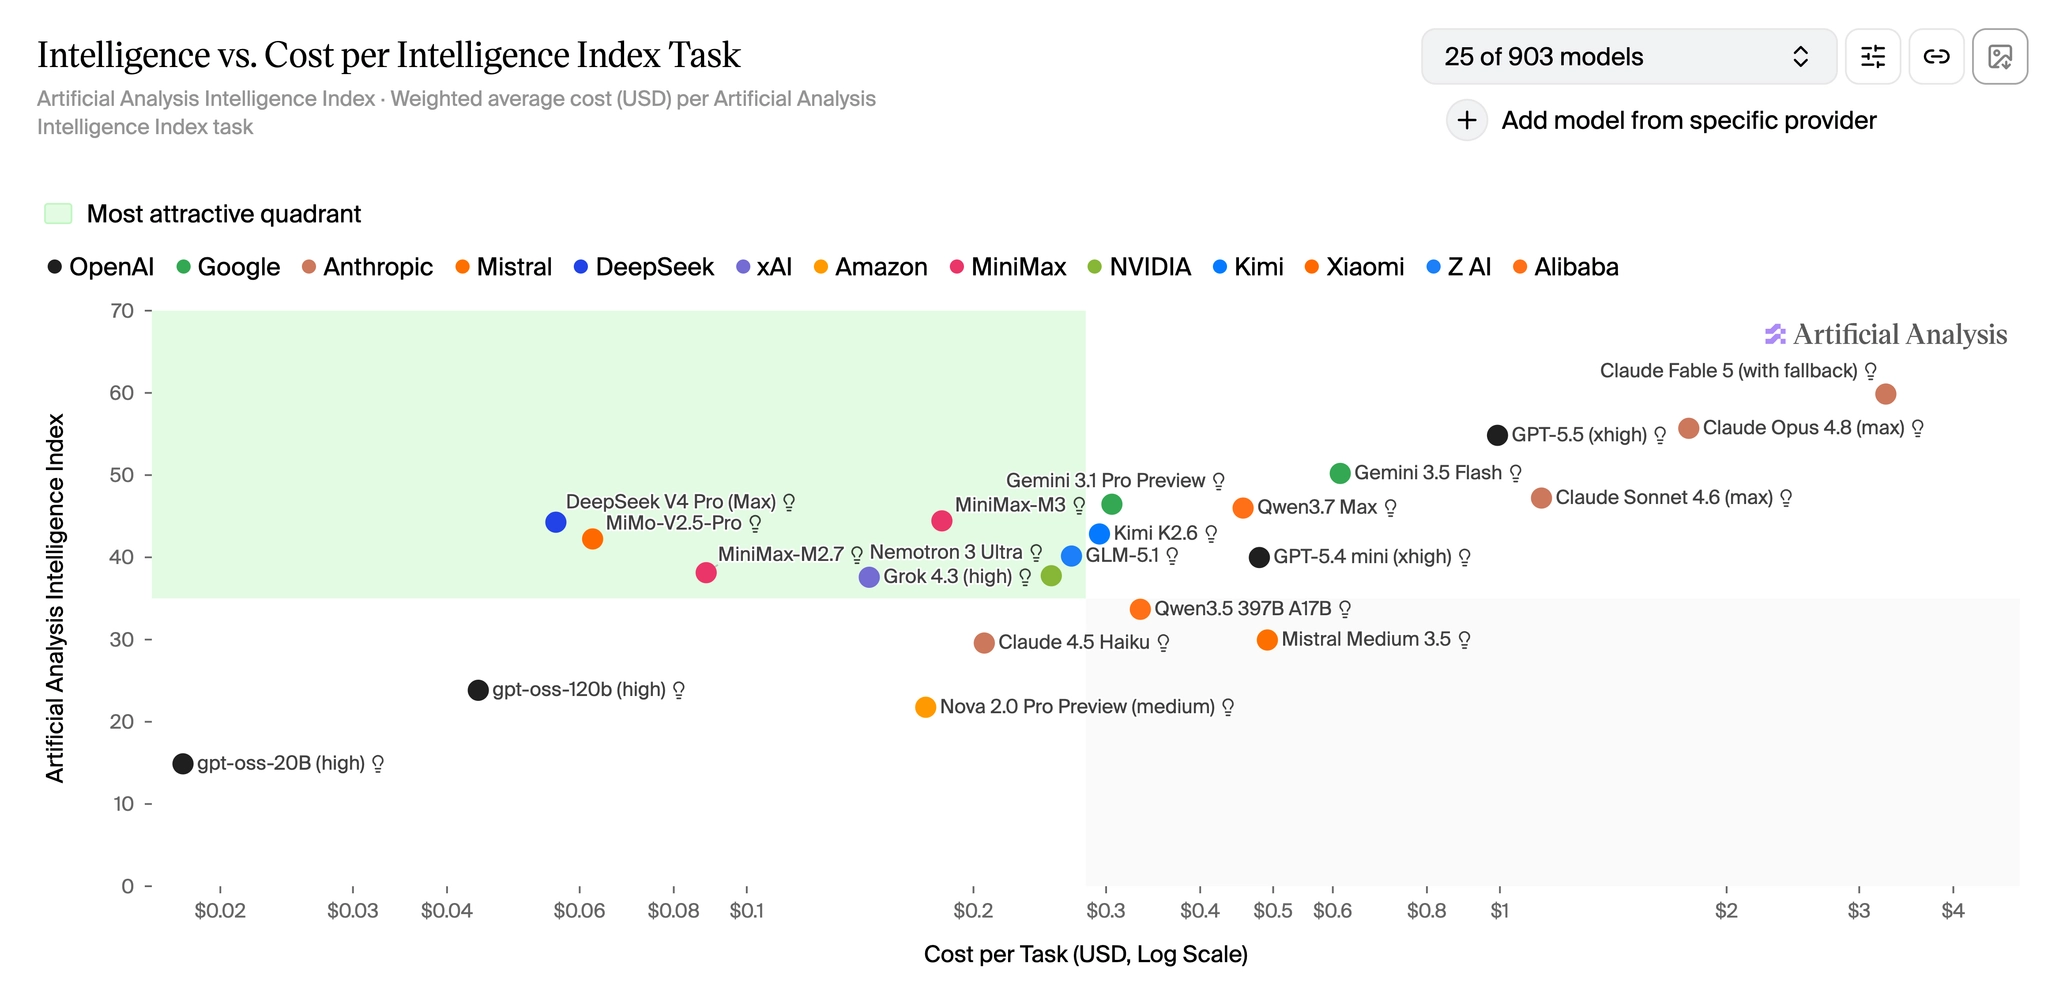
「斩杀线」叙事的数据原型是 Artificial Analysis Intelligence Index 散点图(下为 2048×1008 官方高清版,点击可放大拖动、逐一看清模型名);自媒体刷屏的「斩杀线」图是它的 AI 改写示意(见下方存档)。

Artificial Analysis Intelligence Index v4.1 高清原图
高清原图 · Artificial Analysis Intelligence Index v4.1(2026-07-31 提取)· 网传斩杀线图的数据原型点击放大
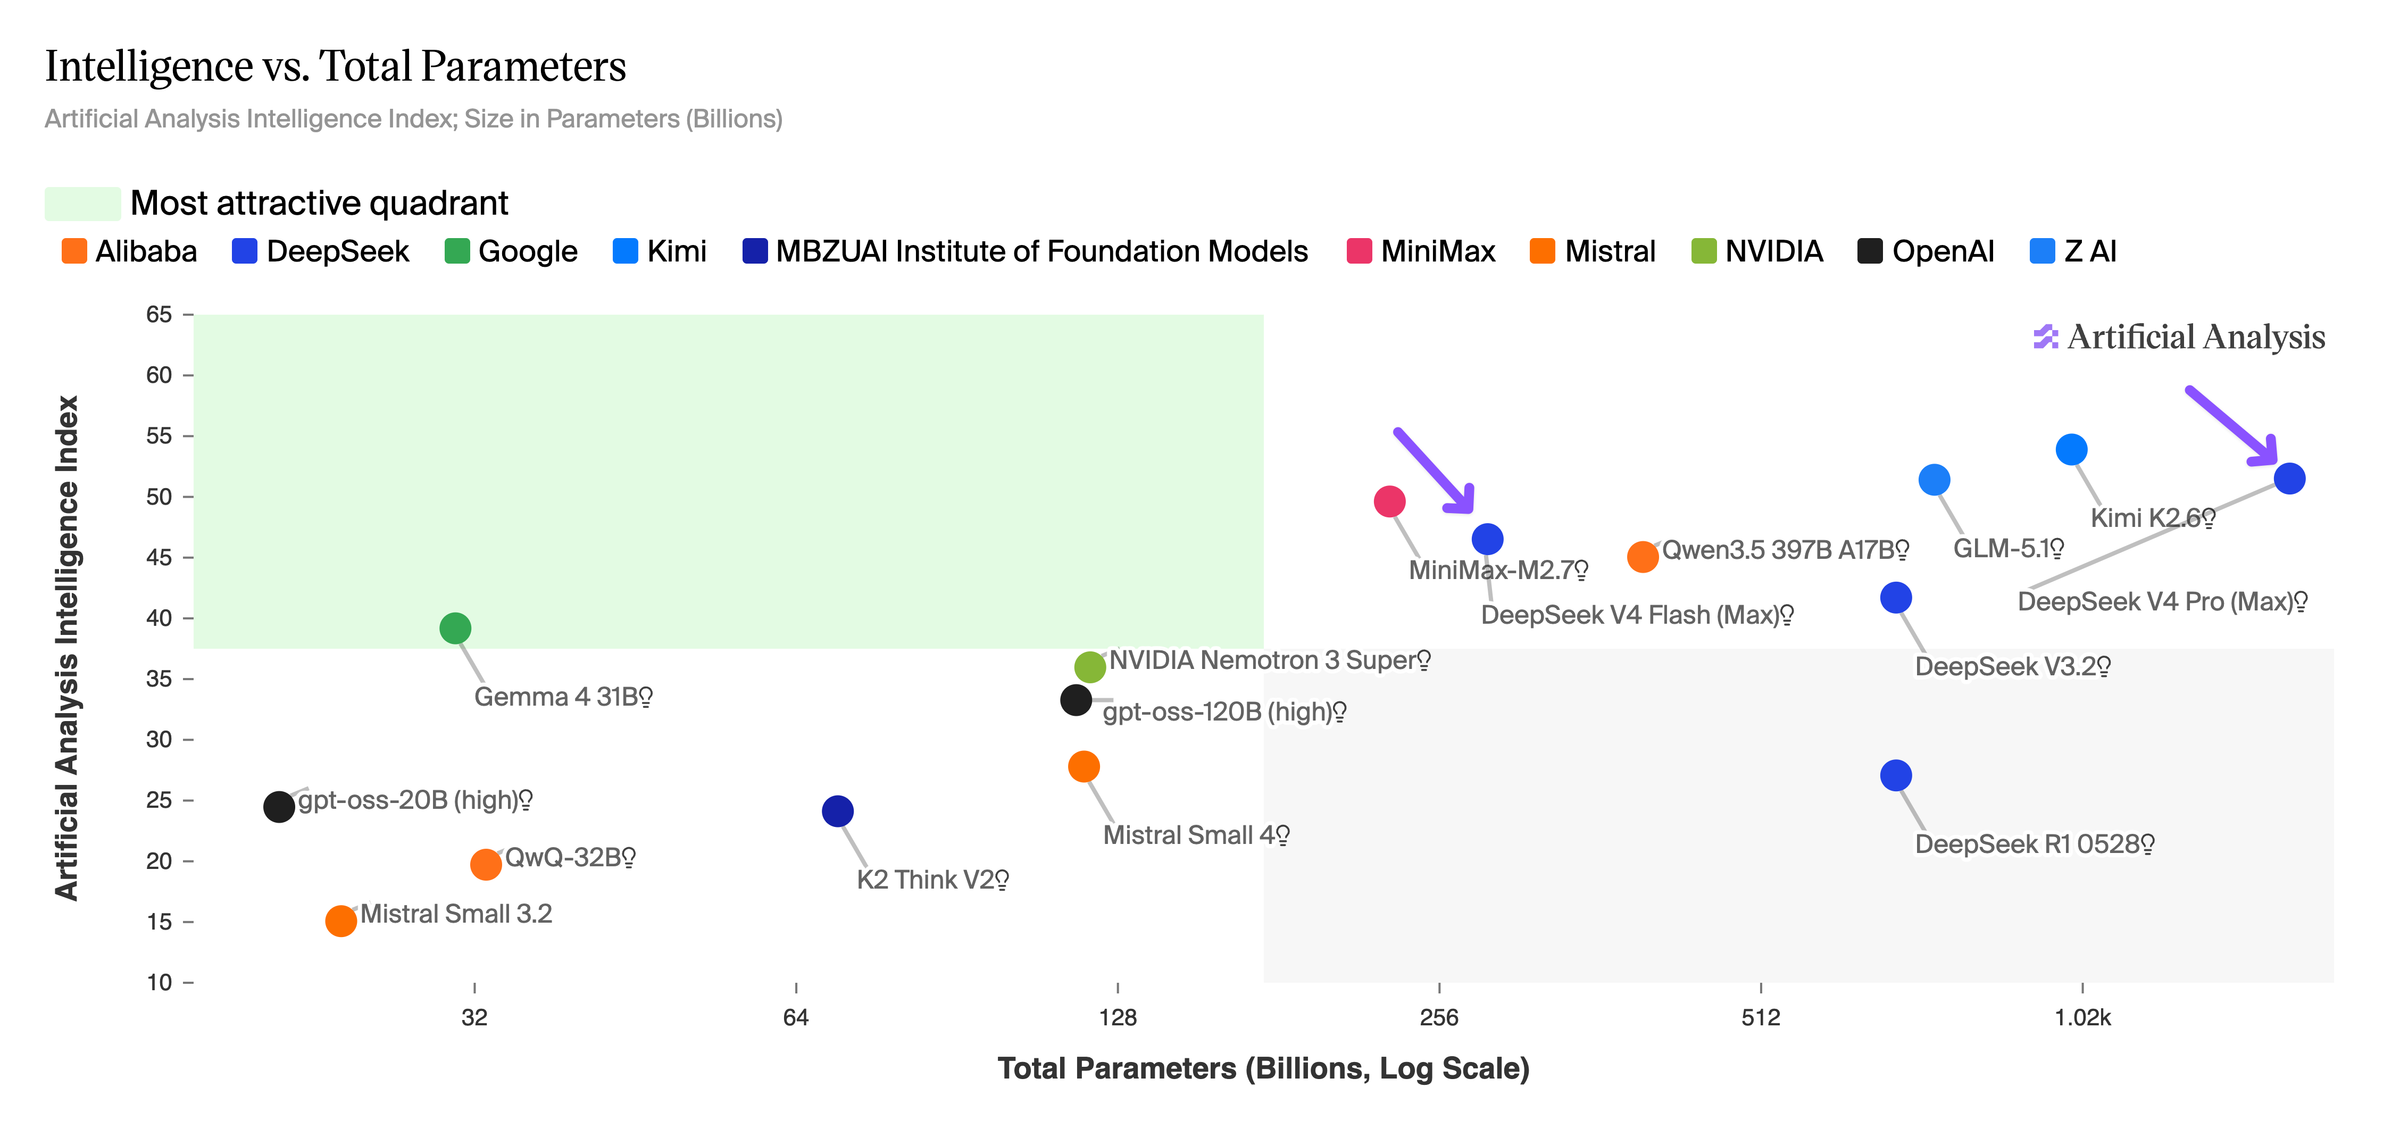
DeepSeek is back amongst the frontier 高清图
同系列精简版:「DeepSeek is back amongst the frontier」(2400×1123)点击放大
自媒体斩杀线示意图
自媒体 AI 示意图(低清存档)· 新浪新闻配图 2026-08-03 · 横轴「加权分」无出处
自媒体变体一
示意图变体 ①
自媒体变体二
示意图变体 ②(千问 3.8 Max 压线版)
自媒体变体三
示意图变体 ③(条形图版)
问题 01
它不是官方榜单
多个 AI 生成变体彼此矛盾:V4 Flash 输入价有的写 $0.28、有的写 $0.14;横轴「综合能力加权分」没有任何出处。
问题 02
SKU 对不上
图里放的是 Kimi K3 Pro、GLM-5.2 Air、千问 3.7 Max——全是各家族另一档。你关心的 K3 / 5.3 / 3.8 Max 是更新的旗舰档,需要重新放点。
问题 03
「斩杀」被误读
斩杀的准确含义是「同能力下价格被碾压」,不是「能力被淘汰」。几乎所有标题都不讲这一点。
03

同一坐标系,换真实数据重画

本节是 08-13 调价前的历史价格快照,用于复盘「斩杀线」叙事;8 月 17 日 DeepSeek 已改为峰谷价,当前价格与比较优势请看第 04 / 05 节。红色虚线是过 V4 Flash 的「L 形斩杀边界」;绿色虚线是 V4 Pro 正式版的预测斩杀边界。

能力 × 价格:08-13 调价前的历史落点
X: SWE-BENCH VERIFIED (%) | Y: OUTPUT PRICE $/M TOKENS (LOG) | 当前峰谷价见第 04 节价格表 | 绿色 = V4 PRO 正式版预测层
0.2 0.5 1 2 5 10 20 78 80 82 84 86 88 90 能力 →(SWE-bench Verified,%) 输出价格($/百万 tokens,对数) 经典斩杀区(红) 能力 ≤ V4 Flash 且更贵 真实数据下:空的 斩杀边界(过 V4 Flash) V4 Pro 正式版·预测斩杀区(绿) 若爆料成立:三旗舰 + GPT-5.5 全部进线,仅剩 Opus 级能力溢出 预测区间:能力 85–88 · 输出 $1.5–4 能力溢出区 贵,但有只有它们能做的事 国产三旗舰:能力 +0.8 ~ +1.7 分 调价前价格贵 6.1 – 13.7 倍 → 性价比被斩杀 DeepSeek V4 Flash 80.6 / $0.42 · 08-13 历史价 GLM-5.3 81.4 / $2.56 Kimi K3 81.5 / $4.00 千问 3.8 Max 82.3 / $5.76 GPT-5.5(约) ~85 / $8.00 Claude Opus 4.6(约) ~88 / $15.00 DeepSeek V4 Pro 正式版(预测) ~86.5 / ~$2.5 · 涨价后预估
斩杀线本体 GLM-5.3 Kimi K3 千问 3.8 Max 海外旗舰(官方口径约数) V4 Pro 正式版·预测斩杀区(绿)
反转点网传图里「V4 Flash 58 分、别人 50 分」的排布与公开基准不符:真实数据里三家国产新旗舰能力全部略高,但都站在红色斩杀边界的右上方——能力略高、价格贵一个数量级。被斩杀的是性价比,不是能力。注意:本图是调价前历史快照。
绿色叠层 · ✅ 08-13 已验证这是 08-08 基于灰度爆料与涨价公告的预测层(当时口径:能力 ~86.5 SWE / 输出 ~$2.5)。08-13 V4 Pro 正式版已发布:旧价实测斩杀位置为 AA 指数 58 分 / 每任务 $0.06(输出 $0.87/M)。8 月 17 日起调价,当前峰谷价见第 04 节价格表。
04

08-18 新格局:峰谷价重画 DeepSeek 优势

两颗炸弹之后又来一次价格重定价:08-12 Grok 4.6(AA 61 追平 Claude Opus 5,每任务成本仅 $0.65)、08-13 DeepSeek V4 Pro 正式版(AA 58,每任务 $0.06,旧价输出 $0.87/M)。

08-17 调价生效:DeepSeek V4 Flash / Pro 引入北京时间峰谷价,非高峰半价;旧的「全天候价格屠夫」说法需要改成「错峰仍极强,高峰明显收窄」。GLM-5.3 与 Grok Build 的 harness 结论不变。

AA Intelligence Index v4.1 全量 128 模型散点(2026-08-13)
最新全量图 · Artificial Analysis Intelligence Index v4.1(2026-08-13,128 个模型)· 左上蓝点 = V4 Pro,顶部紫点 = Grok 4.6点击放大
DeepSeek 当前官方价($/百万 tokens)缓存命中输入缓存未命中输入输出比较优势的新结论
V4 Flash$0.007–0.014$0.22–0.44$0.66–1.32非高峰仍是批量 API 的低价王;高峰仍便宜,但不再是数量级碾压
V4 Pro$0.022–0.044$0.66–1.32$1.98–3.96非高峰仍低于 Kimi / 千问;高峰输出价已接近 Kimi K3,优势转向 1M 上下文、384K 输出与长 Agent
峰值时段北京时间 09:00–12:00、14:00–18:00;其余为非高峰(半价)。价格自 2026-08-17 生效。
08-13 实测重画:九个关键落点(AA 口径)
X: COST PER TASK USD (LOG) | Y: AA INTELLIGENCE INDEX | 数据源:AA V4.1 全量 CSV(08-13)+ 官方定价
45 50 55 60 63 0.02 0.05 0.1 0.2 0.5 1 2 每任务成本 →(USD,对数刻度) AA 智能指数 → 新斩杀区(08-13 历史价):能力 ≤58 且每任务成本 ≥ $0.06 Kimi K3 (max) · GLM-5.3(暂无 AA 分,沿用 5.2 口径) · Grok 4.5 · Claude Opus 5 (medium) 全部进线 斩杀线抬升:50 → 58 分 能力溢出区(≥60) Grok 4.6 把入场价打到 $0.65 DeepSeek V4 Flash 0731 50 / $0.028 · 旧斩杀线 DeepSeek V4 Pro(正式版) 58 / $0.06 · 新斩杀线本体 GLM-5.3(暂无 AA 分,沿用 5.2 口径) 51 / $0.30 Kimi K3 (max) 57.5 / $0.55 · 压线被斩 Grok 4.5 (high) 52.5 / $0.45 Claude Opus 5 (medium) 55.5 / $0.42 · 首次进线 GPT-5.6 Sol (max) 59 / $1.50 · 仅 1 分豁免 Claude Opus 5 (max) 61 / $1.60 Grok 4.6 (high) 61 / $0.65 · 溢出区价格挑战者
旧斩杀线(Flash) 新斩杀线(V4 Pro) GLM-5.3 Kimi K3 Grok 4.6 Claude Opus 5 GPT-5.6 Sol
新格局三句话① 斩杀线抬升:V4 Pro 的能力线仍在 58 分,但价格线不再是单点 $0.06,而是调价后的约 $0.14–$0.27 任务成本区间(按旧 AA 加权成本同比估算)。② 峰谷分化:V4 Flash / Pro 非高峰半价,适合夜间批处理;北京时间工作时段跑实时 Agent,价格优势会显著收窄。③ 中间被两头挤:Grok 4.6 的溢出区价格优势仍在,DeepSeek 则从「便宜到无脑」变成「有调度能力才便宜」。
预测 vs 实测08-08 预测命中了能力方向,但价格需要二次复盘:V4 Pro 输出从旧价 $0.87/M 调到 $1.98/M(非高峰)或 $3.96/M(高峰)。它仍比 Kimi K3 / 千问便宜,但「斩杀力度远超预测」只适用于 08-13–08-16 的窗口价;现在应改讲「错峰仍强,高峰收窄」。
新口径性价比指数:AA 指数 ÷ 每任务成本(V4 Flash = 100,08-13 历史价快照)
V4 Flash 0731旧价 $0.028 / 50 分
100
V4 Pro旧价 $0.06 / 58 分
54.1
GLM-5.3(暂无 AA 分,沿用 5.2 口径)$0.30 / 51 分
9.5
Kimi K3 (max)$0.55 / 57.5 分
5.9
Grok 4.6 (high)$0.65 / 61 分
5.3
GPT-5.6 Sol (max)$1.50 / 59 分
2.2
Claude Opus 5 (max)$1.60 / 61 分
2.1
讲法纯性价比 V4 Flash 仍是王(100),V4 Pro 次之(54.1)——但 Pro 把「能买到的最高能力」从 50 分抬到 58 分,只贵 2.1 倍。Grok 4.6(5.3)的性价比是 Claude Opus 5(2.1)的 2.5 倍,顶部不再是「贵也得买」。两个新主角的完整优劣势见第 06 节。
05

斩杀线的量化:性价比指数

性价比指数 = SWE-bench 分数 ÷ 输出价,以 V4 Flash 非高峰价 = 100 归一化。DeepSeek 现在是峰谷价,表中采用非高峰官方价;高峰时 V4 Flash / Pro 同时翻倍,二者相对排序不变,但与其他模型的差距会缩小。

DeepSeek V4 Flash$0.66 off-peak / 80.6 分
100
V4 Pro$1.98 off-peak / ~81 分(SWE 为旧口径)
33.5
GLM-5.3沿用 5.2 口径:$2.56 / 81.4 分
8.2
Kimi K3$4.00 / 81.5 分
5.2
千问 3.8 Max$5.76 / 82.3 分
6.9
GPT-5.5(约)$8.00 / ~85 分
4.4
Claude Opus 4.6(约)$15.00 / ~88 分
2.4
讲法调价后,V4 Flash 的非高峰性价比仍是第一,但从旧价基准 100 看,V4 Pro 从 48.5 降到 33.5:它依然比 GLM-5.3、Kimi K3、千问 3.8 Max 高约 4–6 倍,却不再是过去那种「一个数量级碾压」。高峰价下 DeepSeek 两款同时翻倍,适合把批量任务放到非高峰;实时工作时段要把调度成本算进去。
05A

Flash 王座之争:DeepSeek V4 Flash vs GLM-5.3 Flash

这不是旗舰总榜,而是给学员和粉丝看的“最高性价比默认模型”专题。一个更快、适合纯文本流水线;一个更聪明、原生看图,能把结果做到可交付。真正该比的是完成一个合格任务的总成本,而不是只看每百万 Token。

结

没有永久单一价格王,默认选择随时间与任务变化

现在到 09-09:GLM 限时半价,独立能力更高、任务成本还略低,适合当默认模型。促销结束后:能错峰的纯文本批处理优先 DeepSeek;白天实时、图片/视频/Office/前端视觉交付优先 GLM。最终签字仍应由人完成。

PURE-TEXT THROUGHPUT

DeepSeek V4 Flash

纯文本吞吐王 · 可错峰的后台流水线
AA 51.77速度 119.4 t/s上下文 1M主模型 文本输入
$0.22 / $0.66非高峰:普通输入 / 输出,每百万 Token
$0.44 / $1.32高峰:普通输入 / 输出,北京 09–12、14–18 工作日
  • 输出速度约为 GLM 的 2.38 倍,大批量任务等待更短
  • 缓存命中输入最低 $0.007/M,适合重复长前缀与稳定工作流
  • 支持 thinking / non-thinking、工具调用和 384K 最大输出
  • 独立 AA 能力低约 5.69 分;复杂 Agent 更容易因返工吃掉价差
  • 主模型不是原生视觉;视觉是独立实验 SKU,不能当同一能力使用
最佳任务:文章/评论批量清洗、分类、摘要、结构化抽取、简单草稿、快速代码样板、夜间异步任务。
DELIVERABLE COMPLETION

GLM-5.3 Flash

交付闭环王 · 视觉 Agent 与专业文件
AA 57.46速度 50.2 t/s上下文 1M原生 图像/视频/文件
$0.075 / $0.25当前 50% 促销:普通输入 / 输出,至 09-09 24:00 UTC+8
$0.15 / $0.50长期标价:普通输入 / 输出;缓存输入 $0.03/M
  • AA 能力约高 11%,适合更复杂的工具链和最终交付
  • 原生多模态:能看页面、图片、视频、文件并用渲染反馈继续修
  • 官方面向 PPTX / PDF / DOCX / XLSX、金融研究、GUI 与 Computer Use
  • 速度明显慢于 DeepSeek;强制 thinking,不适合极低延迟短任务
  • 当前最低价是限时活动,促销后必须按长期标价重新算账
最佳任务:视觉前端、Office/PPT/Excel 交付、视频理解、金融研究、GUI 操作、需要“生成—渲染—检查—修复”的 Agent。
NOW → 09-09

促销期默认 GLM

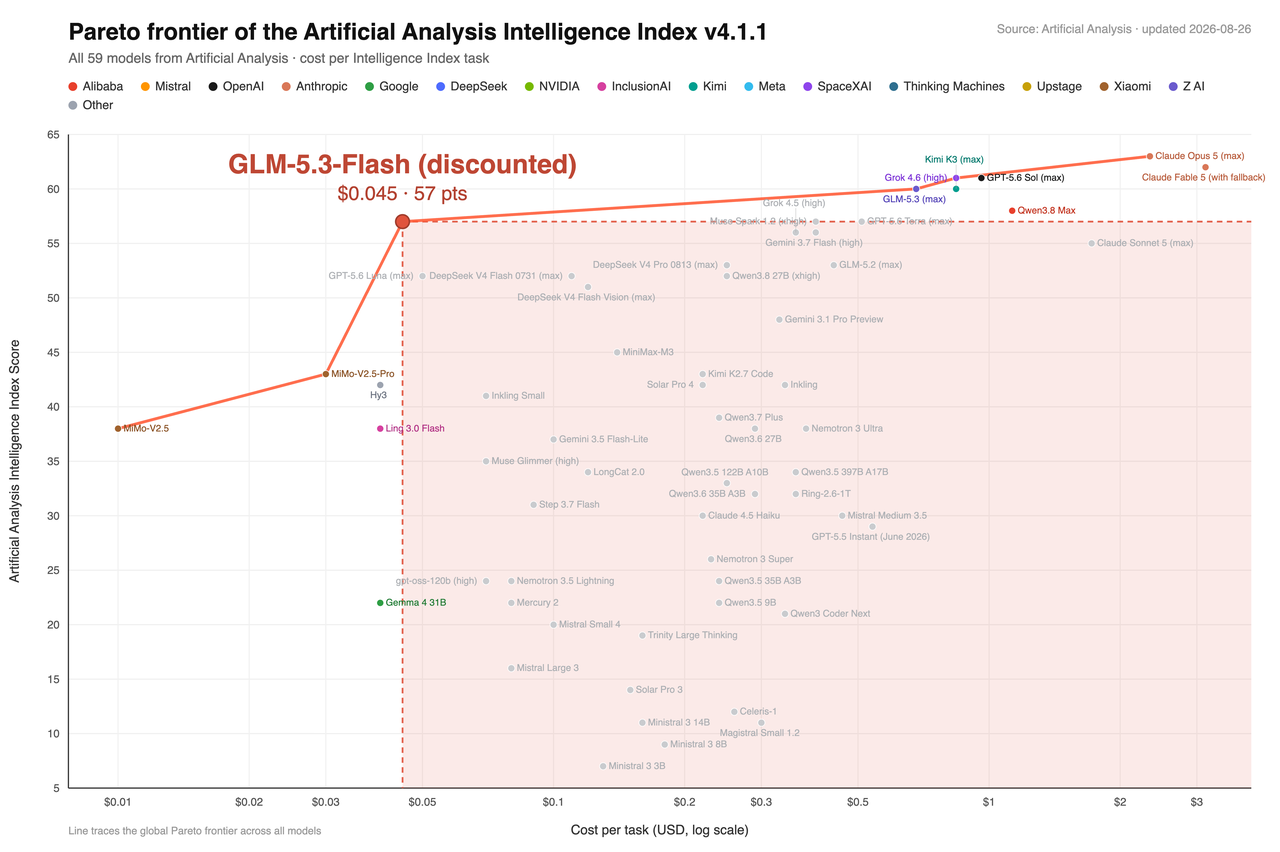
AA 任务成本约 $0.045,比 DeepSeek 非高峰约 $0.055 还低约 18%,能力同时更高。

AFTER PROMO

夜间纯文本选 DeepSeek

促销后 GLM 长期约 $0.09/task;DeepSeek 非高峰约 $0.055,便宜约 39%。

WORK HOURS

白天实时要重算

DeepSeek 高峰约 $0.11/task,比 GLM 长期约 $0.09 贵约 22%,低价标签不再自动成立。

FINAL DELIVERY

视觉闭环选 GLM

只要任务需要看图、看渲染或交付 Office 文件,少一次返工通常比省几分钱 Token 更值。

同口径硬数据:能力、任务成本与速度 Artificial Analysis
AA Intelligence Index v4.1.1 | 任务成本按相同加权任务;价格活动与峰谷由官方费率推算
智能指数:GLM 更强57.46 vs 51.77
GLM-5.3 FlashAA 57.459
57.46
DeepSeek V4 FlashAA 51.767
51.77
输出速度:DeepSeek 更快119.4 vs 50.2 tokens/s
DeepSeek V4 Flash第三方测得 119.4 t/s
119.4
GLM-5.3 Flash第三方测得 50.2 t/s
50.2
每任务成本:胜者随时间变化越短越便宜;GLM 当前活动价作为 100% 比例基准
GLM 当前促销$0.045 / task
$0.045
DeepSeek 非高峰$0.055 / task(按高峰半价)
$0.055
GLM 长期标价$0.09 / task
$0.09
DeepSeek 高峰$0.11 / task
$0.11
关键如果 GLM 能把“文字或代码”直接做成通过视觉检查的页面、PPT、Excel 或视频交付物,而 DeepSeek 需要再交给第二个模型返工,那么 GLM 即使单次 Token 更贵,每个合格交付物也可能更便宜。
用户真正关心的维度DeepSeek V4 FlashGLM-5.3 Flash本轮建议
批量文本速度快、峰谷低价、缓存极便宜能力更高但强制思考、速度较慢DeepSeek:清洗、分类、摘要、初稿
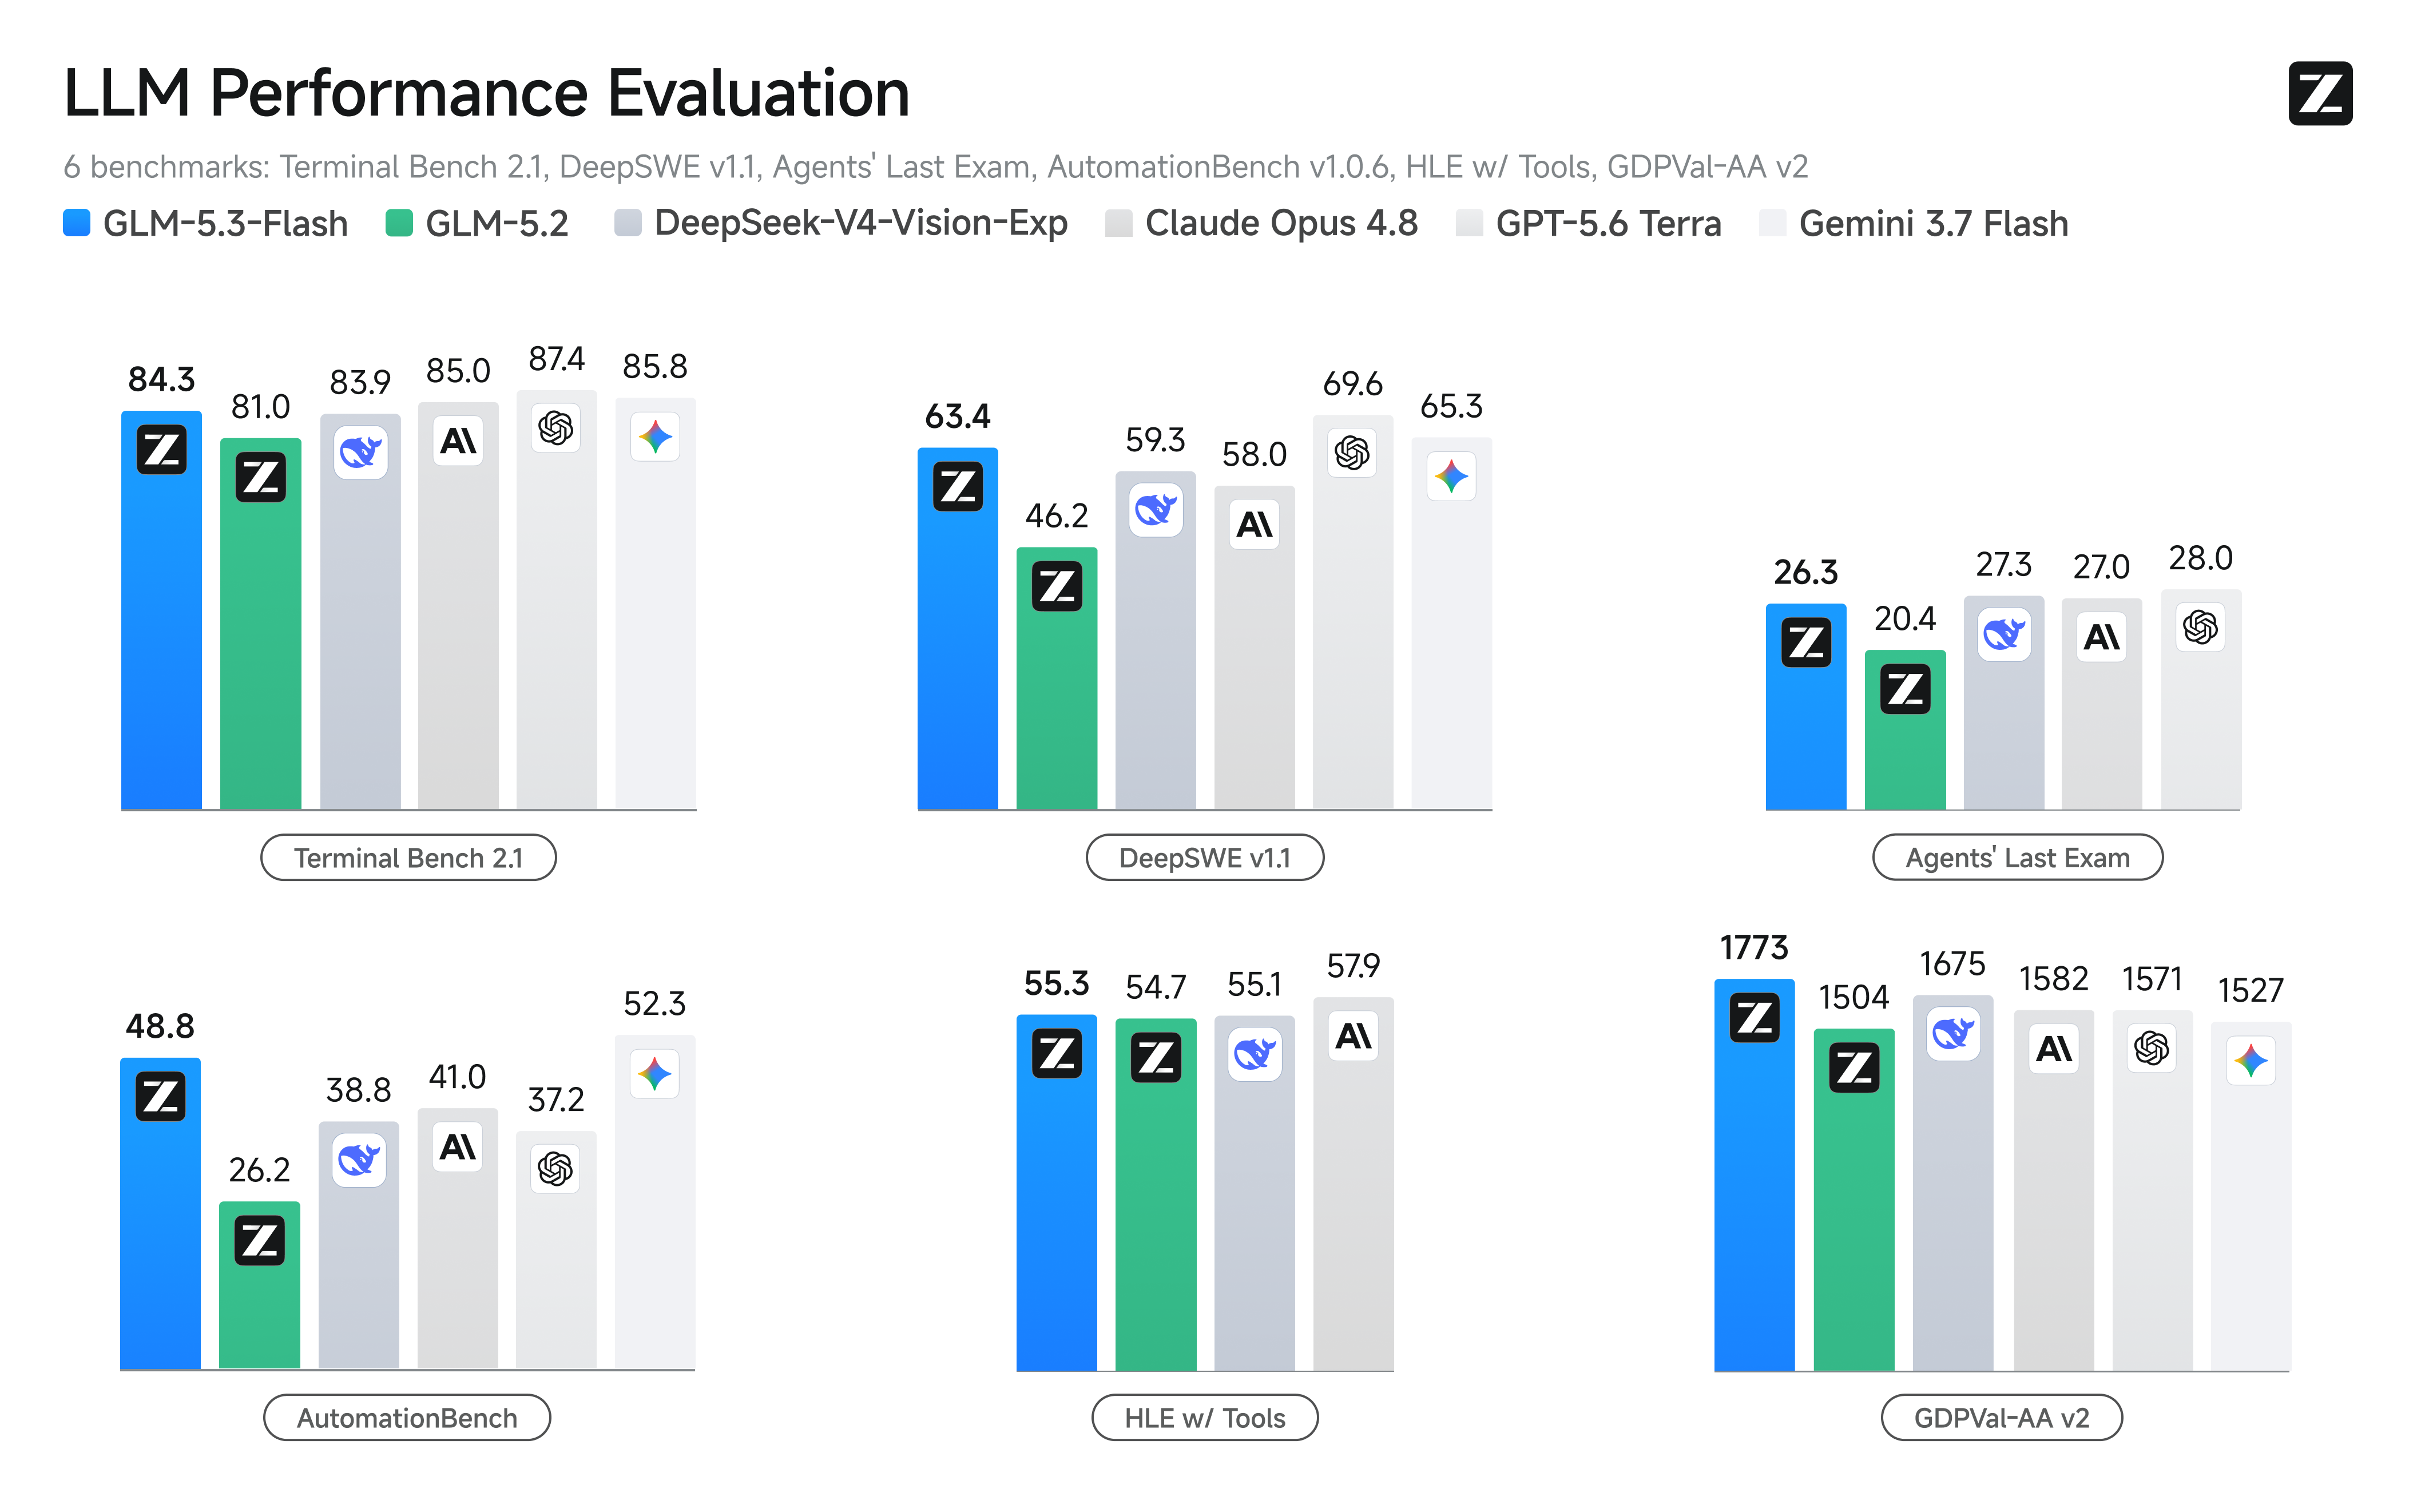
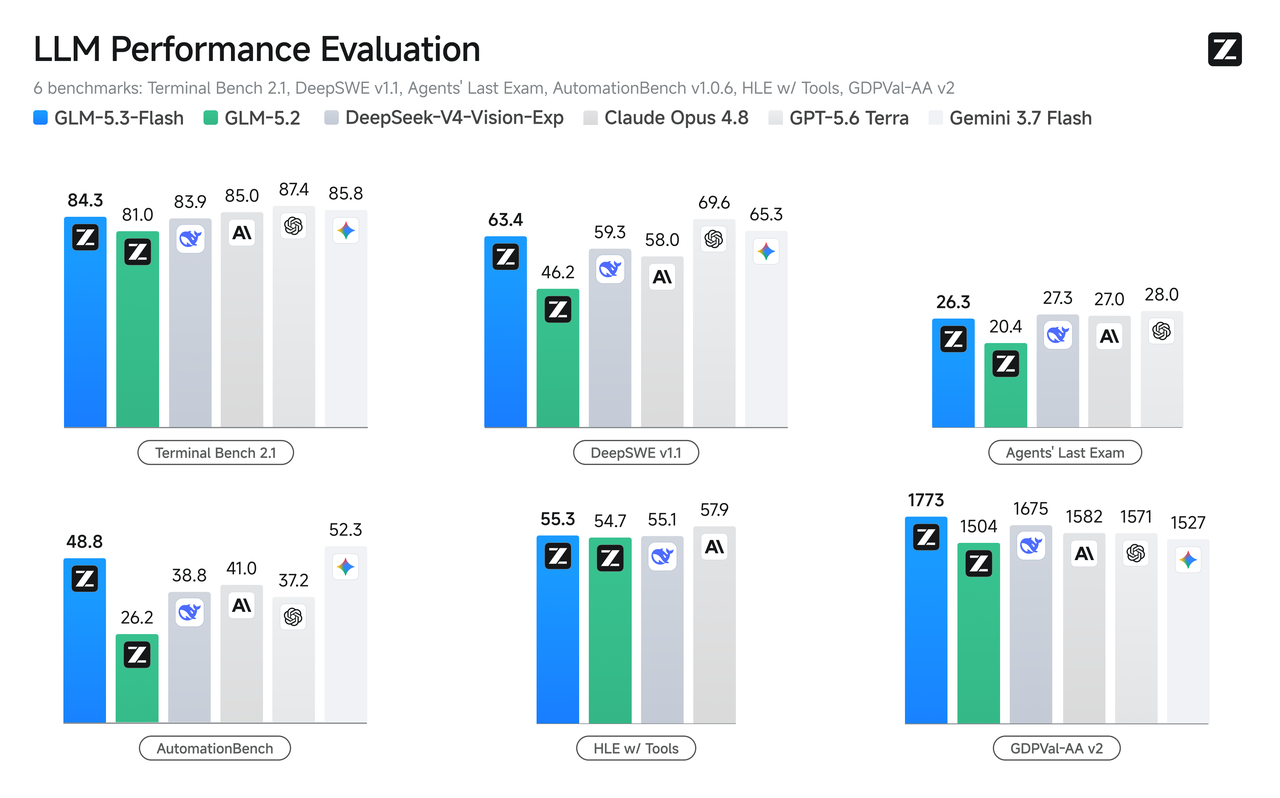
编程 Agent适合快速代码、测试生成、异步批量重构DeepSWE 63.4、AutomationBench 48.8(Z.ai 自报)且能看渲染反馈纯代码吞吐 DS;视觉闭环 GLM
前端与 GUI主模型无原生视觉,需额外视觉实验 SKU 或外部验收原生视觉编码、浏览器/GUI/Computer UseGLM:复刻页面、真机/截图验收
内容与口播便宜地做素材预处理、事实抽取与多版本粗稿能理解视频、画面、字幕与文件,但中文细腻成稿仍需人或写作旗舰Flash 做前处理;K3/Opus/人做终稿
Office / 咨询交付文本研究草稿、表格数据预处理官方支持 PPTX、PDF、DOCX、XLSX 与金融模型闭环GLM:可编辑文件 + 渲染 QA
价格确定性工作日峰谷变化,需调度当前半价有明确截止日,长期按标价预算报价时用长期价,活动价只算额外利润
GLM-5.3 Flash 官方完整 benchmark 高清图
Z.ai 官方完整 benchmark 总图(4239×2643)· 厂商自报,适合看各任务结构,不与 DeepSeek 不同 harness 硬拼点击放大
GLM-5.3 Flash Artificial Analysis 性价比前沿图
AA 性价比前沿 · $0.045/task 为当前促销口径点击放大
GLM-5.3 Flash 编程和 Agent benchmark 图
编程 / Agent 图 · Z.ai 自报,脚注含具体 harness点击放大

最赚钱的不是二选一,而是把两者接成低成本交付流水线

① DeepSeek 批量预处理夜间清洗素材、去重、分类、抽取事实、生成结构草稿,把廉价吞吐吃满。
→
② GLM 做可交付文件结合图片/视频/参考页面,完成前端、PPT、Excel、报告或可操作界面,并真实渲染检查。
→
③ 人工签字与产品化核事实、合规、语气和商业判断;按“内容资产包 / 自动化系统 / 管理层报告”收费,不按 Token 收费。
CASE 01 · 内容业务

科技口播素材资产包

DeepSeek批量拆热点资料、去重和提炼证据;GLM理解视频/截图并整理时间线;K3/Opus/人完成细腻中文成稿。

可收费交付:选题地图 + 3 个开头 + 3–5 分钟口播 + 事实卡 + 发布素材清单
CASE 02 · 企业服务

管理层周报 / 投研包

DeepSeek处理大量文本和表格;GLM生成带公式的 Excel、可编辑 PPT 与 PDF,并渲染检查溢出和错位。

可收费交付:结论页 + 数据底稿 + 可编辑模型 + 风险清单 + 更新服务
CASE 03 · 自动化

前端复刻与运营后台

DeepSeek快速生成组件和测试样板;GLM看参考图、运行浏览器、比截图并修正,直到主要流程真实可用。

可收费交付:部署地址 + 源码 + 测试证据 + 使用说明 + 月度维护
UNIT ECONOMICS

每周只记三个数字

每个合格交付物的总成本、返工率、交付时间。如果便宜模型让返工翻倍,它就不是性价比模型。

经营原则:报价按长期标价;把促销、缓存和错峰节省留成毛利安全垫
06

七位主角,各自的优劣势

没有「最好的模型」,只有「某个场景下性价比最高的模型」。08-13 起新增 V4 Pro(新斩杀线本体)与 Grok 4.6(溢出区价格挑战者);08-28 腾讯 混元 Hy4 preview 开源加入。

Kimi K307-17 · 开源
审美与长上下文的内容旗舰 · 月之暗面
输出 $4.00/M上下文 1MSWE 81.5%速度 48–62 t/s
  • 前端/网页审美全场第一档,官方主打 high-aesthetic webdev
  • 1M 上下文;与 V4 Flash / V4 Pro 同档,支持视觉多模态
  • 开源可自部署;订阅套餐额度慷慨
  • 慢:48–62 tok/s,官方定位「慢而省」,约为 GLM-5.3 一半
  • 输出价在国产三家里偏贵,是 V4 Flash 的 9.5 倍
适合日常内容创作 / 前端页面 / 长文档 —— 你已有套餐,继续当主力
GLM-5.308-14 · 开源
Coding Agent 性价比之王(接替 5.2)· 智谱
输出 未公布(5.2 为 $2.56/M)上下文 1M(Coding Plan)TB 2.1 88.2DeepSWE 66.9
  • 同 5.2 基座 + 长任务 RL 后训练:Terminal-Bench 2.1 从 81.0 跳到 88.2,DeepSWE 46.2→66.9,发布即开源 SOTA
  • 长任务 token 效率大幅提升(官方 Code Bench 内部提升约 50%),Agent 项目更省 token
  • Coding Plan 约 ¥20/月起不变:3 倍 Claude Pro 用量、1/7 价格
  • AA 指数与正式 API 定价尚未公布(目前仅 Coding Plan 可用),本页沿用 5.2 的 51 分 / $0.30 口径
  • 开源权重约 8 月底放出;内容创作与审美口碑仍弱于 K3
适合编程 Agent / 自动化脚本 —— 5.3 把「最划算编程订阅」的门槛又抬高了
千问 3.8 Max07-26 · 闭源
推理与知识准确性的闭源旗舰 · 阿里
输出 $5.76/M(国际刊例)上下文 256KSWE 82.3%AIME 95.8
  • 数学/复杂推理全场最强:AIME 26 95.8(第一)、HLE 53.6(最高)、GPQA 89.4
  • 幻觉最少:AA omniscience 指数 12,知识型回答最可靠
  • SWE-bench 82.3% 代码第一梯队;阿里云企业级生态与 SLA
  • 闭源:不能本地部署、不能私有微调(其余三家全开源)
  • 上下文 256K 最短(K3 的 1/4);国产阵营 API 最贵
  • C 端通义 App 体验平庸——但免费额度够你试
适合数学/推理/知识密集型内容、阿里云生态团队、To B 交付
DeepSeek V4 Flash2026-05 · 开源
错峰低价王 · 深度求索
输出 $0.66–1.32/M缓存输入 $0.007–0.014SWE 80.6%速度 69–112 t/s
  • 非高峰仍是价格屠夫:输出 $0.66/M,缓存命中输入 $0.007/M;高峰价也仍低于多数竞品
  • 开源 + 1M 上下文 + 速度不慢;数学意外不错(AIME 93.5)
  • 绝对能力比三家新旗舰低 0.8–1.7 SWE 分,复杂 Agent 任务翻车率更高
  • 7 月底「默认注入 Codex 上下文」争议,部分复测分数低于官方口径
适合夜间批量 API / 成本敏感后台任务 —— 调度到非高峰,优势最大
DeepSeek V4 Pro08-13 · 开源
峰谷价下的长 Agent 旗舰 · 深度求索
输出 $1.98–3.96/M输入 $0.66–1.32/MAA 58上下文 1M
  • 能力线仍在 58 分:AA 位置没有变,但调价后不再是全天候单点价格屠杀
  • 非高峰仍有明显优势:$1.98/M 输出 + 1M 上下文 + 384K 最大输出,适合调度型长 Agent
  • 开源权重;支持 high / xhigh 推理档;缓存命中价极低
  • 正式版 SWE-bench 官方复测未发布(~81% 为 Preview/Max 档旧口径),编程定位待复测确认
  • 高峰输出 $3.96/M 已接近 Kimi K3 的 $4.00/M;实时工作时段不再拥有数量级优势
适合错峰批量 API / 长上下文 Agent —— 优势从“便宜”转为“可调度 + 长输出 + 开源”
Grok 4.608-12 · 闭源
溢出区价格挑战者 · xAI
输出 $6.00/M输入 $2.00/MAA 61速度 68 t/s
  • 知识型写作/研究当前最强档:GDPVal-AA 1753 第一(知识工作任务),AA 61 追平 Claude Opus 5
  • 编辑器编程第一:CursorBench 69.9%;同能力下每任务成本只有 Opus 5 (max) 的 40%
  • 缓存输入 $0.50/M,长上下文重复调用成本可控
  • Agentic 编程仍非最强:DeepSWE 65.9、Terminal-Bench 58.3,落后 GPT-5.6 Sol(71.7 / 66.5)——但 xAI 内部 Grok Build 编码 harness 的 SWE 高达 79.3,公开基准可能只是下限
  • 首 token 延迟 ~42s 偏慢,交互式写作体感一般;闭源
适合深度研究 / 知识写作 / 分析 —— 顶部第一次有「不买 Claude 也行」的选择
混元 Hy4 preview08-28 · 开源 · Apache 2.0
腾讯开源新旗舰 · 1M 上下文生产力模型
输出 $2.50/M输入 $0.83/M上下文 1M770B/49B MoE
  • 官方自报 TB 2.1 88.4(与 GLM-5.3 的 88.2 同版口径)并列开源第一档;SWE-bench V. 82.7、AIME 26 99.0、LiveCodeBench v6 84.4 均高于 K3 / GLM-5.3 / V4 Pro 官方口径
  • Apache 2.0 开源权重 + MTP 投机解码 + Gated DSA 稀疏注意力(类 DeepSeek/GLM 路线),1M 上下文 serving 成本可控
  • 腾讯内部盲评(163 专家 / 203 工程任务)小幅领先 GLM 5.3(46.8% 胜)与 Kimi K3(51.2% 胜)——厂商自报
  • 发布仅一天:AA 指数与第三方复测均未收录,benchmark 以官方自报为主,需等独立验证
  • 官方承认已知问题:复杂任务过度推理、过度自我验证,响应偏长、耗时偏久
  • OpenRouter 上架价 $0.83/$2.50 已接近 V4 Pro 高峰价,不是低价角色,定位是开源旗舰而非屠夫
$2.50输出 / M(OpenRouter 上架价)· 适合 编程 / Office 交付 / 游戏开发 / 科研 —— 等第三方复测再定档
混元 Hy4 preview 官方 benchmark 总图(对照 K3 / V4 Pro / GLM-5.3)
混元 Hy4 preview 官方 benchmark 总图(厂商自报口径,对照 K3 / V4 Pro / GLM-5.3;TB 2.1 与 GLM-5.3 同版可比,其余以第三方复测为准)点击放大
「Harness 溢价」:同一模型,不同 harness 跑出不同分数
官方内部 harness 结果 = 能力上限,公开 API 基准 = 能力下限 | 来源:DeepSeek / xAI 官方披露
DeepSeek Harness官方内测的长时间编码 harness 中,DeepSeek 模型跑通「24h+ 连续编码、百万行级交付」——斩杀线的含义从「单次问答便宜」升级为「跑得起长 Agent 项目」。这解释了为什么 V4 Pro 的 SWE 旧口径(~81%)与 AA 指数(58)观感不一致:harness 内表现 ≠ 单次基准。
Grok BuildxAI 内部的编码 harness:Grok 4.6 在其中跑出 SWE 79.3,远高于公开 API 基准(DeepSWE 65.9 / TB 58.3)。含义:① 编程场景「模型分」越来越依赖 harness 工程;② 对比时不要跨 harness 口径直接比——GLM-5.3 的 TB 2.1 88.2 与 Grok Build 的 SWE 79.3 不是同一套题。
维度V4 FlashV4 ProKimi K3GLM-5.3千问 3.8 MaxGrok 4.6混元 Hy4
写作 / 内容中规中矩,胜在便宜长文 + 低价首选,批量写作流水线中文内容第一档:审美 + 1M 长文 + 套餐慷慨内容/审美口碑弱于 K3知识型内容最稳(幻觉最少,AA omniscience 12)知识型写作/研究最强档:GDPVal-AA 1753 第一官方主打 Office / 分析报告交付(厂商自报),暂无第三方口碑
前端 / 审美一般一般(未单独标注)公认第一档(官方主打 high-aesthetic webdev)一般中上未单独标注官方称视觉审美有提升(厂商自报),待验证
编程(SWE-bench)80.6%~81%(Preview/Max 旧口径,正式版未复测)81.5%未公布(5.2 为 81.4%)82.3%未公布;Grok Build 内部 SWE 79.3;编辑器场景 CursorBench 69.9% 第一82.7%(官方自报 V. 版口径,待第三方复测)
Agentic 编程TB 2.3:58.1;官方 Harness 跑通 24h+ 连续编码未复测;Harness 内百万行级交付~64(版本口径存疑)TB 2.1:88.2(接替 5.2 的 81.0),DeepSWE 66.9TB 2.3:67.5TB 58.3、DeepSWE 65.9,落后 GPT-5.6 Sol(66.5 / 71.7)TB 2.1:88.4(官方自报,与 GLM-5.3 同版口径;τ2-Bench 83.5)
数学 / 推理AIME 93.5(意外不错)未公布(AA 58 档)第一梯队第一梯队全场最强:AIME 95.8、HLE 53.6、GPQA 89.4AA 61 档,推理第一梯队AIME 26:99.0 / GPQA-D:80.3 / HLE:41.7(均官方自报)
速度69–112 t/s未公布48–62 t/s(慢而省)~115 t/s(官方归一化口径)未公布68 t/s,但 TTFT ~42s 偏慢未公布;默认 high 推理档偏慢,官方承认存在过度推理 / 过度自我验证
上下文1M1M(最大输出 384K)1M1M(Coding Plan 路由)256K未公布1M
输出价 $/M0.66–1.321.98–3.964.00未公布(5.2 为 2.56)5.766.00(缓存输入 0.50)2.50(OpenRouter 上架价,输入 0.834)
开源✅✅✅✅❌❌✅ Apache 2.0(770B/49B MoE)
07

你的体感 × 公开数据对照

你的三条 Kimi K3 体感,全部被公开数据印证;千问 3.8 Max「贵不贵」要分场景回答。

你的体感 / 问题
公开数据验证
结论
K3 套餐用量完全够用
Kimi 订阅额度在同档产品中偏慷慨;K3 开源 + 1M 上下文
✓ 成立
K3 响应非常慢
实测 48–62 tok/s,官方定位「慢而省」,约为 GLM-5.3 的一半
✓ 成立 · 是设计取向
K3 前端审美不错
官方主打 high-aesthetic frontend/webdev,多篇第三方实测认可
✓ 成立
千问 3.8 Max 是不是很贵?
API 国产最贵($5.76/M),但只是 Claude 的 38%;C 端通义 App 免费额度可用
分场景 · 先用免费额度
08

真正能落地的用法:从模型选择到收入

模型比较的终点不是“谁分数最高”,而是把不同模型接进一条能交付、能复用、能收费的工作流。下面按真实产出拆分,不按品牌站队。

内容增长 / 科技口播

把研究、写作、发布拆成三段

Grok 4.6找最新事实、争议点和 X 上的原始讨论;千问 3.8 Max做事实核验;Kimi K3把材料改成中文口播长文,再由人补上判断、案例和个人语气。

可交付:一个选题 → 1 条 60–90 秒口播 + 3 个开头 + 标题/评论区引导。按“内容包”收费,不按 token 收费。
编程 Agent / 自动化交付

快模型迭代,长模型收尾

GLM-5.3负责日常改代码、跑测试和快速迭代;DeepSeek V4 Pro负责长任务、长上下文和批量重构;Kimi K3做前端审美和最终体验检查。关键节点保留人工验收。

可交付:把一次性脚本包装成“部署 + 文档 + 维护”的小系统,收入来自结果和后续服务,而不是调用量。
知识服务 / 咨询研究

卖判断,不卖一堆 AI 字

Grok 4.6做跨来源研究和观点地图;千问查错、补证据;Kimi K3 或 Opus完成面向客户的细腻表达。最终交付必须有结论、证据、风险和下一步。

可交付:行业简报、竞品地图、课程大纲、决策备忘录。客户买的是节省的决策时间。
成本与规模

让贵模型只做最后 20%

V4 Flash在非高峰批量处理清洗、分类和初稿;V4 Pro处理长 Agent 和难任务;K3、Grok 或 Opus 只用于决定成败的结构、语气和最终交付。每周记录成本、返工率和交付时间。

判断标准:不是单次 token 最便宜,而是“每个合格交付物”的总成本最低。
01 / 先定结果

写清验收标准

先定义客户拿到什么、什么算合格,再选模型。

02 / 再拆流程

让模型各做擅长的段

研究、核验、生成、审校不要强行由一个模型包办。

03 / 留人把关

关键判断必须人工

事实、立场、合规和最后一版语气不能无人签字。

04 / 产品化

按结果打包收费

把一次交付沉淀成模板、SOP 和复购服务。

09

给学员的讲解要点

五条,可直接照讲。

1
先讲概念
斩杀线 = 「同等能力下,价格被碾压即死亡」的性价比线,不是能力线。自媒体标题几乎都不讲这个区别。
2
再讲反转
近 30 天的真实数据里,国产三个新旗舰能力全部略高于 V4 Flash,但价格贵 6–14 倍——所以它们在性价比维度确实「进线」了。
3
GPT/Claude 为什么例外
不是性价比高(按口径它们更差),而是能力溢出:仍存在只有它们能完成的任务。这是「按值论价」,不是「按价论价」。
4
顺手讲媒介素养
网传图是 AI 生成的自媒体示意图:多个版本数据互相矛盾、坐标轴无出处。看到刷屏结论,先问一句「数据口径是什么」。
5
最后讲怎么选
内容/审美/长文档 → Kimi K3;编程 Agent → GLM-5.3(接替 5.2,TB 2.1 88.2);数学推理/知识准确 → 千问 3.8 Max;批量 API/长文写作流水线 → V4 Flash 或 V4 Pro(能力更高、仍极便宜);深度研究/知识写作 → Grok 4.6(不买 Claude 也行的顶部选择)。按场景分工,而不是二选一。
6
08-17 补充:峰谷价改变优势
DeepSeek 的能力线没有变,但价格从单点变成峰谷区间:Flash 输出 $0.66–1.32/M,Pro $1.98–3.96/M。非高峰仍强,高峰收窄;有调度能力才便宜。讲批量 API 时一定把北京工作时段的高峰价算进去。